
JEPA и общие представления визуальных и языковых моделей
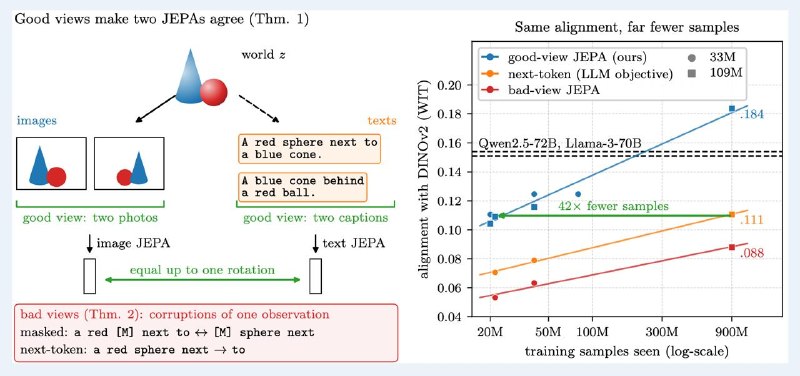
Раньше уже писал про Platonic Representation Hypothesis, а также Emergent Symbolic Structure of Artificial Neural Networks — и вот свежее продолжение темы:
Proving and Improving the Platonic Representation Hypothesis with JEPAs
По слову JEPA в названии можно сразу догадаться, что Ян Лекун среди авторов :-)
Результат: независимо обученные визуальные и языковые модели строят представления, которые отличаются только поворотом. Представление визуальной модели можно повернуть, передать в языковую — и на выходе будет описание картинки. Интерактивное демо прилагается.
Очень большой прогресс последнее время в понимании того, как работают нейронки (еще недавний результат). И, чтобы два раза не вставать, — LLMs can natively read & write neural network weights: Астра руками правит веса маленького Qwen, чтобы он лучше работал.
Думаю, мы на пороге больших открытий.
Автор: Григорий Петросян