
Модели и цены
В хабе — модели Anthropic, OpenAI, DeepSeek, z.ai и Moonshot AI. Все они доступны по одному ключу, оплачиваются с одного баланса и видны в одной аналитике.
Модели
В запросе модель указывается идентификатором из списка — так же, как у самого провайдера:
| Провайдер | Модели |
|---|---|
| Anthropic | claude-opus-5-5 claude-opus-5 claude-sonnet-5-5 claude-sonnet-5 claude-fable-5-1 claude-haiku-4-5-20251001 |
| OpenAI | gpt-6.1-sol gpt-6-sol gpt-6-astra gpt-6-luna gpt-5.6-sol gpt-5.6-terra gpt-5.6-luna gpt-5.5-pro gpt-5.4-mini gpt-5.4-nano |
| DeepSeek | deepseek-v4-pro deepseek-flash |
| z.ai | glm-5.3 glm-5.3-flash glm-5.3-flashx |
| Moonshot AI | kimi-k3 kimi-k2.7-code kimi-k2.7-code-highspeed |
Модели и цены регулярно обновляются. Актуальный список с ценами — в разделе «Тарифы» в хабе, а для программ — в ответе GET /openai/api/v1/models.
Выбор модели в агенте
Codex и Claude Code получают каталог моделей от хаба, поэтому модели разных провайдеров появляются прямо в их меню выбора модели. Если у модели нет прямого маршрута для протокола агента, хаб конвертирует запросы сам.
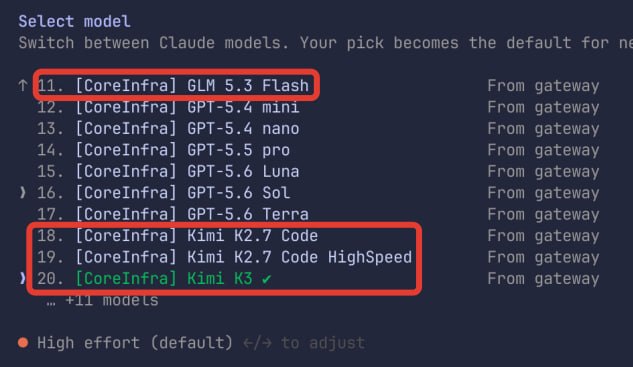
Модели хаба в Claude Code.
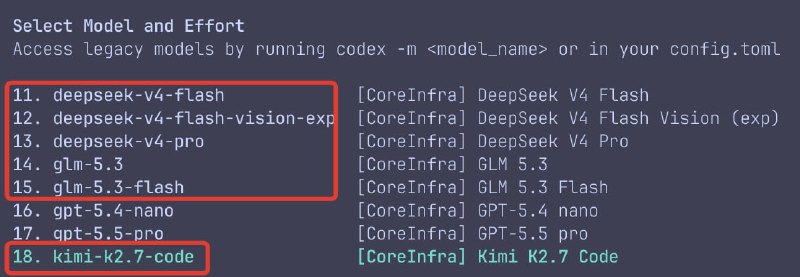
Модели хаба в Codex.
Из чего складывается стоимость
Цены указаны в рублях за миллион токенов. Токен — элементарный блок текста, которым оперирует модель, обычно несколько символов. В запросе учитываются:
- Input — весь входной контекст: системный промпт, история диалога, код, файлы, описания инструментов и результаты их вызовов.
- Output — ответ модели вместе с её рассуждениями. Рассуждения (reasoning) входят в output и выделяются только в аналитике.
- Cache Read — часть контекста, уже посчитанная раньше. Такие токены заметно дешевле обычного input, поэтому кэш сильно снижает стоимость агентской работы.
- Cache Write — запись контекста в кэш. У Anthropic запись на 5 минут и на 1 час тарифицируется по-разному, некоторые провайдеры запись не тарифицируют.
Стоимость запроса =
  ( Input       × тариф Input
  + Cache Read  × тариф Cache Read
  + Cache Write × тариф Cache Write
  + Output      × тариф Output ) / 1 000 000
Веб-поиск, которым пользуются агенты, оплачивается отдельно — за каждый запрос. У части моделей действует тариф длинного контекста: если на входе больше 200 000 токенов, input стоит вдвое дороже, а output — в полтора раза. Подробнее о типах токенов — в статье блога «Что тарифицируют LLM-провайдеры».
Резерв и списание
Пока запрос выполняется, хаб держит на балансе резерв — оценку его стоимости. Когда ответ получен, хаб списывает фактическую стоимость по токенам и снимает резерв. Если доступного остатка не хватает на новый запрос, хаб отклонит его и сообщит баланс, сумму резерва и доступный остаток со ссылкой на страницу оплаты.